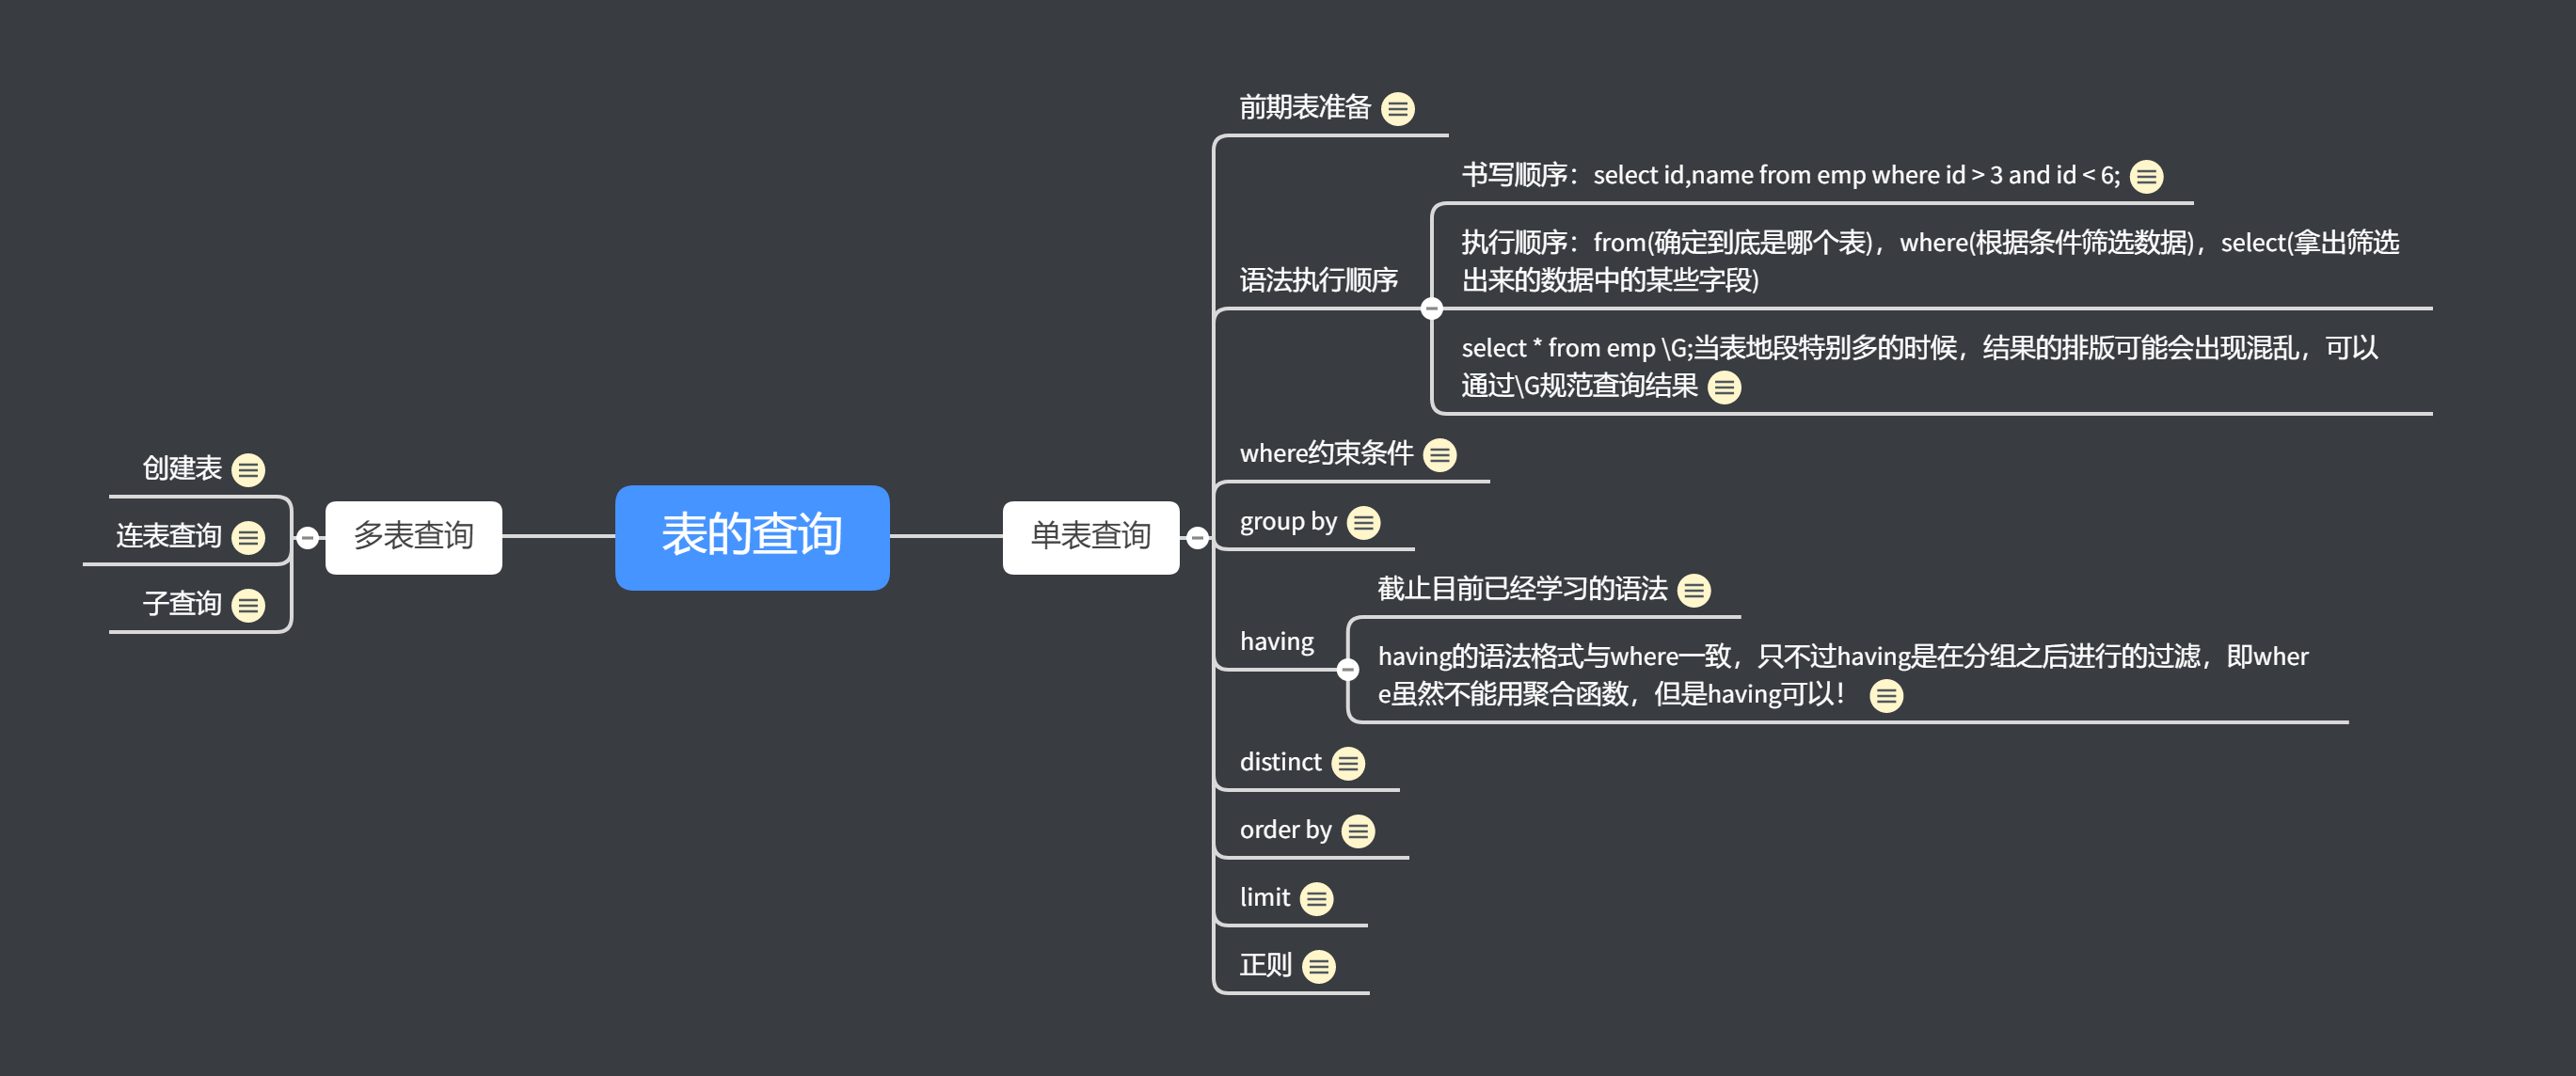
单表查询
前期表准备
create table emp(
  id int not null unique auto_increment,
  name varchar(20) not null,
  sex enum('male','female') not null default 'male',  # 大部分是男的
  age int(3) unsigned not null default 28,
  hire_date date not null,
  post varchar(50),
  post_comment varchar(100),
  salary double(15,2),
  office int,  # 一个部门一个屋子
  depart_id int
);# 插入记录# 三个部门:教学,销售,运营insert into emp(name,sex,age,hire_date,post,salary,office,depart_id) values
('jason','male',18,'20170301','张江第一帅形象代言',7300.33,401,1),  # 以下是教学部
('egon','male',78,'20150302','teacher',1000000.31,401,1),
('kevin','male',81,'20130305','teacher',8300,401,1),
('tank','male',73,'20140701','teacher',3500,401,1),
('owen','male',28,'20121101','teacher',2100,401,1),
('jerry','female',18,'20110211','teacher',9000,401,1),
('nick','male',18,'19000301','teacher',30000,401,1),
('sean','male',48,'20101111','teacher',10000,401,1),
('歪歪','female',48,'20150311','sale',3000.13,402,2),  # 以下是销售部门
('丫丫','female',38,'20101101','sale',2000.35,402,2),
('丁丁','female',18,'20110312','sale',1000.37,402,2),
('星星','female',18,'20160513','sale',3000.29,402,2),
('格格','female',28,'20170127','sale',4000.33,402,2),
('张野','male',28,'20160311','operation',10000.13,403,3),  # 以下是运营部门
('程咬金','male',18,'19970312','operation',20000,403,3),
('程咬银','female',18,'20130311','operation',19000,403,3),
('程咬铜','male',18,'20150411','operation',18000,403,3),
('程咬铁','female',18,'20140512','operation',17000,403,3);
# ps:如果在windows系统中,插入中文字符,select的结果为空白,可以将所有字符编码统一设置成gbk
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
| id | name      | sex    | age | hire_date  | post                        | post_comment | salary     | office | depart_id |
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
|  1 | jason     | male   |  18 | 2017-03-01 | 张江第一帅形象代言          | NULL         |    7300.33 |    401 |         1 |
|  2 | egon      | male   |  78 | 2015-03-02 | teacher                     | NULL         | 1000000.31 |    401 |         1 |
|  3 | kevin     | male   |  81 | 2013-03-05 | teacher                     | NULL         |    8300.00 |    401 |         1 |
|  4 | tank      | male   |  73 | 2014-07-01 | teacher                     | NULL         |    3500.00 |    401 |         1 |
|  5 | owen      | male   |  28 | 2012-11-01 | teacher                     | NULL         |    2100.00 |    401 |         1 |
|  6 | jerry     | female |  18 | 2011-02-11 | teacher                     | NULL         |    9000.00 |    401 |         1 |
|  7 | nick      | male   |  18 | 1900-03-01 | teacher                     | NULL         |   30000.00 |    401 |         1 |
|  8 | sean      | male   |  48 | 2010-11-11 | teacher                     | NULL         |   10000.00 |    401 |         1 |
|  9 | 歪歪      | female |  48 | 2015-03-11 | sale                        | NULL         |    3000.13 |    402 |         2 |
| 10 | 丫丫      | female |  38 | 2010-11-01 | sale                        | NULL         |    2000.35 |    402 |         2 |
| 11 | 丁丁      | female |  18 | 2011-03-12 | sale                        | NULL         |    1000.37 |    402 |         2 |
| 12 | 星星      | female |  18 | 2016-05-13 | sale                        | NULL         |    3000.29 |    402 |         2 |
| 13 | 格格      | female |  28 | 2017-01-27 | sale                        | NULL         |    4000.33 |    402 |         2 |
| 14 | 张野      | male   |  28 | 2016-03-11 | operation                   | NULL         |   10000.13 |    403 |         3 |
| 15 | 程咬金    | male   |  18 | 1997-03-12 | operation                   | NULL         |   20000.00 |    403 |         3 |
| 16 | 程咬银    | female |  18 | 2013-03-11 | operation                   | NULL         |   19000.00 |    403 |         3 |
| 17 | 程咬铜    | male   |  18 | 2015-04-11 | operation                   | NULL         |   18000.00 |    403 |         3 |
| 18 | 程咬铁    | female |  18 | 2014-05-12 | operation                   | NULL         |   17000.00 |    403 |         3 |
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
语法执行顺序
书写顺序:select id,name from emp where id > 3 and id < 6;
+----+-------+
| id | name  |
+----+-------+
|  3 | kevin |
|  4 | tank  |
|  5 | owen  |
|  6 | jerry |
+----+-------+
执行顺序:from(确定到底是哪个表),where(根据条件筛选数据),select(拿出筛选出来的数据中的某些字段)
select * from emp \G;当表地段特别多的时候,结果的排版可能会出现混乱,可以通过\G规范查询结果
*************************** 1. row ***************************
          id: 1
        name: jason
         sex: male
         age: 18
   hire_date: 2017-03-01
        post: 张江第一帅形象代言
post_comment: NULL
      salary: 7300.33
      office: 401
   depart_id: 1
*************************** 2. row ***************************
          id: 2
        name: egon
         sex: male
         age: 78
   hire_date: 2015-03-02
        post: teacher
post_comment: NULL
      salary: 1000000.31
      office: 401
   depart_id: 1
...
where约束条件
# 1.查询id大于等于3小于等于6的数据select id,name from emp where id>= 3 and id <= 6;
select *  from emp where id between 3 and 6;
# 上述语句完全等价
+----+-------+
| id | name  |
+----+-------+
|  3 | kevin |
|  4 | tank  |
|  5 | owen  |
|  6 | jerry |
+----+-------+# 2.查询薪资是20000或者18000或者17000的数据select * from emp where salary = 20000 or salary = 18000 or salary = 17000;
select * from emp where salary in (20000,18000,17000);  # 简写
+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+
| id | name      | sex    | age | hire_date  | post      | post_comment | salary   | office | depart_id |
+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+
| 15 | 程咬金    | male   |  18 | 1997-03-12 | operation | NULL         | 20000.00 |    403 |         3 |
| 17 | 程咬铜    | male   |  18 | 2015-04-11 | operation | NULL         | 18000.00 |    403 |         3 |
| 18 | 程咬铁    | female |  18 | 2014-05-12 | operation | NULL         | 17000.00 |    403 |         3 |
+----+-----------+--------+-----+------------+-----------+--------------+----------+--------+-----------+
# 3.查询员工姓名中包含o字母的员工姓名和薪资# 在你刚开始接触mysql查询的时候,建议你按照查询的优先级顺序拼写出你的sql语句
# 先是查哪张表 from emp ,再是根据什么条件去查 where name like ‘%o%’ ,再是对查询出来的数据筛选展示部分 select name,salary"""
模糊匹配 like
    %:匹配多个任意字符
    _:匹配一个任意字符
"""select name,salary from emp where name like '%o%';
+-------+------------+
| name  | salary     |
+-------+------------+
| jason |    7300.33 |
| egon  | 1000000.31 |
| owen  |    2100.00 |
+-------+------------+# 4.查询员工姓名是由四个字符组成的员工姓名与其薪资select name,salary from emp where name like '____';
select name,salary from emp where char_length(name) = 4;
# 上述语句完全等价
+------+------------+
| name | salary     |
+------+------------+
| egon | 1000000.31 |
| tank |    3500.00 |
| owen |    2100.00 |
| nick |   30000.00 |
| sean |   10000.00 |
+------+------------+# 5.查询id小于3或者大于6的数据select * from emp where id < 3 or id > 6;select *  from emp where id not between 3 and 6;
# 上述语句完全等价
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
| id | name      | sex    | age | hire_date  | post                        | post_comment | salary     | office | depart_id |
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
|  1 | jason     | male   |  18 | 2017-03-01 | 张江第一帅形象代言          | NULL         |    7300.33 |    401 |         1 |
|  2 | egon      | male   |  78 | 2015-03-02 | teacher                     | NULL         | 1000000.31 |    401 |         1 |
|  7 | nick      | male   |  18 | 1900-03-01 | teacher                     | NULL         |   30000.00 |    401 |         1 |
|  8 | sean      | male   |  48 | 2010-11-11 | teacher                     | NULL         |   10000.00 |    401 |         1 |
|  9 | 歪歪      | female |  48 | 2015-03-11 | sale                        | NULL         |    3000.13 |    402 |         2 |
| 10 | 丫丫      | female |  38 | 2010-11-01 | sale                        | NULL         |    2000.35 |    402 |         2 |
| 11 | 丁丁      | female |  18 | 2011-03-12 | sale                        | NULL         |    1000.37 |    402 |         2 |
| 12 | 星星      | female |  18 | 2016-05-13 | sale                        | NULL         |    3000.29 |    402 |         2 |
| 13 | 格格      | female |  28 | 2017-01-27 | sale                        | NULL         |    4000.33 |    402 |         2 |
| 14 | 张野      | male   |  28 | 2016-03-11 | operation                   | NULL         |   10000.13 |    403 |         3 |
| 15 | 程咬金    | male   |  18 | 1997-03-12 | operation                   | NULL         |   20000.00 |    403 |         3 |
| 16 | 程咬银    | female |  18 | 2013-03-11 | operation                   | NULL         |   19000.00 |    403 |         3 |
| 17 | 程咬铜    | male   |  18 | 2015-04-11 | operation                   | NULL         |   18000.00 |    403 |         3 |
| 18 | 程咬铁    | female |  18 | 2014-05-12 | operation                   | NULL         |   17000.00 |    403 |         3 |
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
# 6.查询薪资不在20000,18000,17000范围的数据select * from emp where salary not in (20000,18000,17000);
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
| id | name      | sex    | age | hire_date  | post                        | post_comment | salary     | office | depart_id |
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
|  1 | jason     | male   |  18 | 2017-03-01 | 张江第一帅形象代言          | NULL         |    7300.33 |    401 |         1 |
|  2 | egon      | male   |  78 | 2015-03-02 | teacher                     | NULL         | 1000000.31 |    401 |         1 |
|  3 | kevin     | male   |  81 | 2013-03-05 | teacher                     | NULL         |    8300.00 |    401 |         1 |
|  4 | tank      | male   |  73 | 2014-07-01 | teacher                     | NULL         |    3500.00 |    401 |         1 |
|  5 | owen      | male   |  28 | 2012-11-01 | teacher                     | NULL         |    2100.00 |    401 |         1 |
|  6 | jerry     | female |  18 | 2011-02-11 | teacher                     | NULL         |    9000.00 |    401 |         1 |
|  7 | nick      | male   |  18 | 1900-03-01 | teacher                     | NULL         |   30000.00 |    401 |         1 |
|  8 | sean      | male   |  48 | 2010-11-11 | teacher                     | NULL         |   10000.00 |    401 |         1 |
|  9 | 歪歪      | female |  48 | 2015-03-11 | sale                        | NULL         |    3000.13 |    402 |         2 |
| 10 | 丫丫      | female |  38 | 2010-11-01 | sale                        | NULL         |    2000.35 |    402 |         2 |
| 11 | 丁丁      | female |  18 | 2011-03-12 | sale                        | NULL         |    1000.37 |    402 |         2 |
| 12 | 星星      | female |  18 | 2016-05-13 | sale                        | NULL         |    3000.29 |    402 |         2 |
| 13 | 格格      | female |  28 | 2017-01-27 | sale                        | NULL         |    4000.33 |    402 |         2 |
| 14 | 张野      | male   |  28 | 2016-03-11 | operation                   | NULL         |   10000.13 |    403 |         3 |
| 16 | 程咬银    | female |  18 | 2013-03-11 | operation                   | NULL         |   19000.00 |    403 |         3 |
+----+-----------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+#
7.查询岗位描述为空的员工名与岗位名  针对null不能用等号,只能用isselect name,post from emp where post_comment = NULL;  # 查询为空!
select name,post from emp where post_comment is NULL;
+-----------+-----------------------------+
| name      | post                        |
+-----------+-----------------------------+
| jason     | 张江第一帅形象代言          |
| egon      | teacher                     |
| kevin     | teacher                     |
| tank      | teacher                     |
| owen      | teacher                     |
| jerry     | teacher                     |
| nick      | teacher                     |
| sean      | teacher                     |
| 歪歪      | sale                        |
| 丫丫      | sale                        |
| 丁丁      | sale                        |
| 星星      | sale                        |
| 格格      | sale                        |
| 张野      | operation                   |
| 程咬金    | operation                   |
| 程咬银    | operation                   |
| 程咬铜    | operation                   |
| 程咬铁    | operation                   |
+-----------+-----------------------------+
select name,post from emp where post_comment is not NULL;
group by
# 数据分组应用场景:每个部门的平均薪资,男女比例等
# 1.按部门分组select * from emp group by post;  # 分组后取出的是每个组的第一条数据
+----+--------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
| id | name   | sex    | age | hire_date  | post                        | post_comment | salary     | office | depart_id |
+----+--------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
| 14 | 张野   | male   |  28 | 2016-03-11 | operation                   | NULL         |   10000.13 |    403 |         3 |
|  9 | 歪歪   | female |  48 | 2015-03-11 | sale                        | NULL         |    3000.13 |    402 |         2 |
|  2 | egon   | male   |  78 | 2015-03-02 | teacher                     | NULL         | 1000000.31 |    401 |         1 |
|  1 | jason  | male   |  18 | 2017-03-01 | 张江第一帅形象代言          | NULL         |    7300.33 |    401 |         1 |
+----+--------+--------+-----+------------+-----------------------------+--------------+------------+--------+-----------+
select id,name,sex from emp group by post;  # 验证
+----+--------+--------+
| id | name   | sex    |
+----+--------+--------+
| 14 | 张野   | male   |
|  9 | 歪歪   | female |
|  2 | egon   | male   |
|  1 | jason  | male   |
+----+--------+--------+"""
分组之后应该做到最小单位是组,而不应该再展示组内的单个数据信息
MySQL中分组之后 只能拿到分组的字段信息 无法直接获取其他字段信息
但是你可以通过其他方法(聚合函数)简介的获取
设置sql_mode为only_full_group_by,意味着以后但凡分组,只能取到分组的依据,
不应该在去取组里面的单个元素的值,那样的话分组就没有意义了,因为不分组就是对单个元素信息的随意获取"""# 如果你的MySQL不报错 说明严格模式没有设置 show variables like '%mode%';
set session  # 当前窗口有效
set global  # 全局有效
set global sql_mode="strict_trans_tables,only_full_group_by";
# 重新链接客户端
select * from emp group by post;  # 报错
select id,name,sex from emp group by post;  # 报错
select post from emp group by post;  # 获取部门信息
+-----------------------------+
| post                        |
+-----------------------------+
| operation                   |
| sale                        |
| teacher                     |
| 张江第一帅形象代言          |
+-----------------------------+# 强调:只要分组了,就不能够再“直接”查找到单个数据信息了,只能获取到组名
# 2.获取每个部门的最高工资     聚合函数 max min avg sum count# 以组为单位统计组内数据>>>聚合查询(聚集到一起合成为一个结果)
# 每个部门的最高工资
select post,max(salary) from emp group by post;
+-----------------------------+-------------+
| post                        | max(salary) |
+-----------------------------+-------------+
| operation                   |    20000.00 |
| sale                        |     4000.33 |
| teacher                     |  1000000.31 |
| 张江第一帅形象代言          |     7300.33 |
+-----------------------------+-------------+
# 给字段取别名
select post as '部门',max(salary) as '最高工资' from emp group by post;
select post '部门',max(salary) '最高工资' from emp group by post;
# 每个部门的最低工资
select post,min(salary) from emp group by post;
+-----------------------------+-------------+
| post                        | min(salary) |
+-----------------------------+-------------+
| operation                   |    10000.13 |
| sale                        |     1000.37 |
| teacher                     |     2100.00 |
| 张江第一帅形象代言          |     7300.33 |
+-----------------------------+-------------+
# 每个部门的平均工资
select post,avg(salary) from emp group by post;
# 每个部门的工资总和
select post,sum(salary) from emp group by post;
# 每个部门的人数
select post,count(age) from emp group by post;
select post,count(salary) from emp group by post;
select post,count(id) from emp group by post;
select post,count(post_comment) from emp group by post;
# 在统计分组内个数的时候 填写任意非空字段都可以完成计数,推荐使用能够唯一标识数据的字段
# 比如id字段
"""
聚合函数会自动将每一个分组内的单个数据做想要的计算,无需你考虑
"""# 3.查询分组之后的部门名称和每个部门下所有的学生姓名# group_concat(分组之后用)不仅可以用来显示除分组外字段还有拼接字符串的作用select post,group_concat(name) from emp group by post;
select post,group_concat(name,"_SB") from emp group by post;
select post,group_concat(name,": ",salary) from emp group by post;
select post,group_concat(salary) from emp group by post;# 4.补充concat(不分组时用)拼接字符串达到更好的显示效果 as语法使用select name as 姓名,salary as 薪资 from emp;
select concat("NAME: ",name) as 姓名,concat("SAL: ",salary) as 薪资 from emp;# 补充as语法 即可以给字段起别名也可以给表起select emp.id,emp.name from emp as t1; # 报错  因为表名已经被你改成了t1
select t1.id,t1.name from emp as t1;# 查询四则运算
# 查询每个人的年薪select name,salary*12 as annual_salary from emp;
select name,salary*12 annual_salary from emp;  # as可以省略
having
截止目前已经学习的语法
select 查询字段1,查询字段2,... from 表名
		where 过滤条件
		group by分组依据
# 语法这么写,但是执行顺序却不一样
from
where
group by
select
having的语法格式与where一致,只不过having是在分组之后进行的过滤,即where虽然不能用聚合函数,但是having可以!
# 1、统计各部门年龄在30岁以上的员工平均工资,并且保留平均工资大于10000的部门select post,avg(salary) from emp
        where age >= 30
        group by post
        having avg(salary) > 10000;# 如果不信你可以将having取掉,查看结果,对比即可验证having用法!
# 强调:having必须在group by后面使用select * from emp having avg(salary) > 10000;  # 报错
distinct
# 对有重复的展示数据进行去重操作
select distinct post from emp;
order by
select * from emp order by salary asc;  # 默认升序排
select * from emp order by salary desc;  # 降序排
select * from emp order by age desc;  # 降序排
# 先按照age降序排,在年轻相同的情况下再按照薪资升序排
select * from emp order by age desc,salary asc;
# 统计各部门年龄在10岁以上的员工平均工资,并且保留平均工资大于1000的部门,然后对平均工资进行排序
select post,avg(salary) from emp
    where age > 10
    group by post
    having avg(salary) > 1000
    order by avg(salary)
    ;
limit
# 限制展示条数
select * from emp limit 3;
# 查询工资最高的人的详细信息
select * from emp order by salary desc limit 1;
# 分页显示
select * from emp limit 0,5;  # 第一个参数表示起始位置,第二个参数表示的是条数,不是索引位置
select * from emp limit 5,5;
正则
select * from emp where name regexp '^j.*(n|y)$';
多表查询
创建表
# 建表
create table dep(
id int,
name varchar(20)
);
create table emp(
id int primary key auto_increment,
name varchar(20),
sex enum('male','female') not null default 'male',
age int,
dep_id int
);
# 插入数据
insert into dep values
(200,'技术'),
(201,'人力资源'),
(202,'销售'),
(203,'运营');
+------+--------------+
| id   | name         |
+------+--------------+
|  200 | 技术         |
|  201 | 人力资源     |
|  202 | 销售         |
|  203 | 运营         |
+------+--------------+
insert into emp(name,sex,age,dep_id) values
('jason','male',18,200),
('egon','female',48,201),
('kevin','male',38,201),
('nick','female',28,202),
('owen','male',18,200),
('jerry','female',18,204);
+----+-------+--------+------+--------+
| id | name  | sex    | age  | dep_id |
+----+-------+--------+------+--------+
|  1 | jason | male   |   18 |    200 |
|  2 | egon  | female |   48 |    201 |
|  3 | kevin | male   |   38 |    201 |
|  4 | nick  | female |   28 |    202 |
|  5 | owen  | male   |   18 |    200 |
|  6 | jerry | female |   18 |    204 |
+----+-------+--------+------+--------+
# 当初为什么我们要分表,就是为了方便管理,在硬盘上确实是多张表,但是到了内存中我们应该把他们再拼成一张表进行查询才合理
连表查询
select * from emp,dep;  # 左表一条记录与右表所有记录都对应一遍>>>笛卡尔积
+----+-------+--------+------+--------+------+--------------+
| id | name  | sex    | age  | dep_id | id   | name         |
+----+-------+--------+------+--------+------+--------------+
|  1 | jason | male   |   18 |    200 |  200 | 技术         |
|  1 | jason | male   |   18 |    200 |  201 | 人力资源     |
|  1 | jason | male   |   18 |    200 |  202 | 销售         |
|  1 | jason | male   |   18 |    200 |  203 | 运营         |
|  2 | egon  | female |   48 |    201 |  200 | 技术         |
|  2 | egon  | female |   48 |    201 |  201 | 人力资源     |
|  2 | egon  | female |   48 |    201 |  202 | 销售         |
|  2 | egon  | female |   48 |    201 |  203 | 运营         |
|  3 | kevin | male   |   38 |    201 |  200 | 技术         |
|  3 | kevin | male   |   38 |    201 |  201 | 人力资源     |
|  3 | kevin | male   |   38 |    201 |  202 | 销售         |
|  3 | kevin | male   |   38 |    201 |  203 | 运营         |
|  4 | nick  | female |   28 |    202 |  200 | 技术         |
|  4 | nick  | female |   28 |    202 |  201 | 人力资源     |
|  4 | nick  | female |   28 |    202 |  202 | 销售         |
|  4 | nick  | female |   28 |    202 |  203 | 运营         |
|  5 | owen  | male   |   18 |    200 |  200 | 技术         |
|  5 | owen  | male   |   18 |    200 |  201 | 人力资源     |
|  5 | owen  | male   |   18 |    200 |  202 | 销售         |
|  5 | owen  | male   |   18 |    200 |  203 | 运营         |
|  6 | jerry | female |   18 |    204 |  200 | 技术         |
|  6 | jerry | female |   18 |    204 |  201 | 人力资源     |
|  6 | jerry | female |   18 |    204 |  202 | 销售         |
|  6 | jerry | female |   18 |    204 |  203 | 运营         |
+----+-------+--------+------+--------+------+--------------+
# 将所有的数据都对应了一遍,虽然不合理但是其中有合理的数据,现在我们需要做的就是找出合理的数据
# 查询员工及所在部门的信息
select * from emp,dep where emp.dep_id = dep.id;
+----+-------+--------+------+--------+------+--------------+
| id | name  | sex    | age  | dep_id | id   | name         |
+----+-------+--------+------+--------+------+--------------+
|  1 | jason | male   |   18 |    200 |  200 | 技术         |
|  2 | egon  | female |   48 |    201 |  201 | 人力资源     |
|  3 | kevin | male   |   38 |    201 |  201 | 人力资源     |
|  4 | nick  | female |   28 |    202 |  202 | 销售         |
|  5 | owen  | male   |   18 |    200 |  200 | 技术         |
+----+-------+--------+------+--------+------+--------------+
# 查询部门为技术部的员工及部门信息
select * from emp,dep where emp.dep_id = dep.id and dep.name = '技术';
+----+-------+------+------+--------+------+--------+
| id | name  | sex  | age  | dep_id | id   | name   |
+----+-------+------+------+--------+------+--------+
|  1 | jason | male |   18 |    200 |  200 | 技术   |
|  5 | owen  | male |   18 |    200 |  200 | 技术   |
+----+-------+------+------+--------+------+--------+
# 将两张表关联到一起的操作,有专门对应的方法
# 1、内连接:只取两张表有对应关系的记录
select * from emp inner join dep on emp.dep_id = dep.id;
+----+-------+--------+------+--------+------+--------------+
| id | name  | sex    | age  | dep_id | id   | name         |
+----+-------+--------+------+--------+------+--------------+
|  1 | jason | male   |   18 |    200 |  200 | 技术         |
|  2 | egon  | female |   48 |    201 |  201 | 人力资源     |
|  3 | kevin | male   |   38 |    201 |  201 | 人力资源     |
|  4 | nick  | female |   28 |    202 |  202 | 销售         |
|  5 | owen  | male   |   18 |    200 |  200 | 技术         |
+----+-------+--------+------+--------+------+--------------+
select * from emp inner join dep on emp.dep_id = dep.id where dep.name = "技术";
+----+-------+------+------+--------+------+--------+
| id | name  | sex  | age  | dep_id | id   | name   |
+----+-------+------+------+--------+------+--------+
|  1 | jason | male |   18 |    200 |  200 | 技术   |
|  5 | owen  | male |   18 |    200 |  200 | 技术   |
+----+-------+------+------+--------+------+--------+
# 2、左连接: 在内连接的基础上保留左表没有对应关系的记录
select * from emp left join dep on emp.dep_id = dep.id;
+----+-------+--------+------+--------+------+--------------+
| id | name  | sex    | age  | dep_id | id   | name         |
+----+-------+--------+------+--------+------+--------------+
|  1 | jason | male   |   18 |    200 |  200 | 技术         |
|  5 | owen  | male   |   18 |    200 |  200 | 技术         |
|  2 | egon  | female |   48 |    201 |  201 | 人力资源     |
|  3 | kevin | male   |   38 |    201 |  201 | 人力资源     |
|  4 | nick  | female |   28 |    202 |  202 | 销售         |
|  6 | jerry | female |   18 |    204 | NULL | NULL         |
+----+-------+--------+------+--------+------+--------------+
# 3、右连接: 在内连接的基础上保留右表没有对应关系的记录
select * from emp right join dep on emp.dep_id = dep.id;
+------+-------+--------+------+--------+------+--------------+
| id   | name  | sex    | age  | dep_id | id   | name         |
+------+-------+--------+------+--------+------+--------------+
|    1 | jason | male   |   18 |    200 |  200 | 技术         |
|    2 | egon  | female |   48 |    201 |  201 | 人力资源     |
|    3 | kevin | male   |   38 |    201 |  201 | 人力资源     |
|    4 | nick  | female |   28 |    202 |  202 | 销售         |
|    5 | owen  | male   |   18 |    200 |  200 | 技术         |
| NULL | NULL  | NULL   | NULL |   NULL |  203 | 运营         |
+------+-------+--------+------+--------+------+--------------+
# 4、全连接:在内连接的基础上保留左、右面表没有对应关系的的记录
select * from emp left join dep on emp.dep_id = dep.id
union
select * from emp right join dep on emp.dep_id = dep.id;
+------+-------+--------+------+--------+------+--------------+
| id   | name  | sex    | age  | dep_id | id   | name         |
+------+-------+--------+------+--------+------+--------------+
|    1 | jason | male   |   18 |    200 |  200 | 技术         |
|    5 | owen  | male   |   18 |    200 |  200 | 技术         |
|    2 | egon  | female |   48 |    201 |  201 | 人力资源     |
|    3 | kevin | male   |   38 |    201 |  201 | 人力资源     |
|    4 | nick  | female |   28 |    202 |  202 | 销售         |
|    6 | jerry | female |   18 |    204 | NULL | NULL         |
| NULL | NULL  | NULL   | NULL |   NULL |  203 | 运营         |
+------+-------+--------+------+--------+------+--------------+
子查询
# 就是将一个查询语句的结果用括号括起来当作另外一个查询语句的条件去用
# 1.查询部门是技术或者人力资源的员工信息
"""
先获取技术部和人力资源部的id号,再去员工表里面根据前面的id筛选出符合要求的员工信息
"""
select * from emp where dep_id in (select id from dep where name = "技术" or name = "人力资源");
+----+-------+--------+------+--------+
| id | name  | sex    | age  | dep_id |
+----+-------+--------+------+--------+
|  1 | jason | male   |   18 |    200 |
|  2 | egon  | female |   48 |    201 |
|  3 | kevin | male   |   38 |    201 |
|  5 | owen  | male   |   18 |    200 |
+----+-------+--------+------+--------+
# 2.每个部门最新入职的员工 思路:先查每个部门最新入职的员工,再按部门对应上联表查询
select t1.id,t1.name,t1.hire_date,t1.post,t2.* from emp as t1
inner join
(select post,max(hire_date) as max_date from emp group by post) as t2
on t1.post = t2.post
where t1.hire_date = t2.max_date
;
"""
记住一个规律,表的查询结果可以作为其他表的查询条件,也可以通过其别名的方式把它作为一张虚拟表去跟其他表做关联查询
"""
select * from emp inner join dep on emp.dep_id = dep.id;
+----+-------+--------+------+--------+------+--------------+
| id | name  | sex    | age  | dep_id | id   | name         |
+----+-------+--------+------+--------+------+--------------+
|  1 | jason | male   |   18 |    200 |  200 | 技术         |
|  2 | egon  | female |   48 |    201 |  201 | 人力资源     |
|  3 | kevin | male   |   38 |    201 |  201 | 人力资源     |
|  4 | nick  | female |   28 |    202 |  202 | 销售         |
|  5 | owen  | male   |   18 |    200 |  200 | 技术         |
+----+-------+--------+------+--------+------+--------------+